
パブリックノートブックを超えて
Kaggle Expertになるまでの1年半
著者:Miz
1. Expertになるまでに1年半かかった
最近KaggleのCompetitions Expertになりました。AIエージェントがコードを書き、強いパブリックノートブックも公開されている時代ですが、自分はここまで1年半もかかりました。
しかも今でもパブリックノートブックに負けることはよくあります。データを見てモデルを作り、実験を繰り返しても、公開されているコードを動かした方が強い。これはなかなか苦しいです。
今回はそんな壁にどう向き合ってきたかを書きます。CMIでの苦戦とROGIIでのメダル獲得、そして体力の少ない自分がKaggleを続けるために変えてきたこと。その振り返りです。
2. CMIでぶつかったパブリックノートブックの壁
パブリックノートブックは、ほかの参加者が公開してくれているプログラムです。データの読み込みから予測や提出までまとまっているものも多く、コンペに取り組むうえで本当に助かります。
ただ、自分でモデルを作り始めるとその強さが壁になります。
2025年のCMIでは公開ノートブックを参考にしながら進め、途中から独自のモデルを実装しました。ところが手元のCVがなかなか上がりません。CVは学習データを分割し、未知のデータに対する性能を手元で確かめるための検証です。
いろいろ試しても改善せず、一度限界を感じてコンペから少し距離を置きました。その後は強い公開ノートブックの再現に取り組み、そこに自分なりの工夫を加える方針へ戻しています。
最後は友人にも助けてもらい、公開ノートブックをもとにしたアンサンブルを提出。それでもメダルには届きませんでした。当時の振り返り
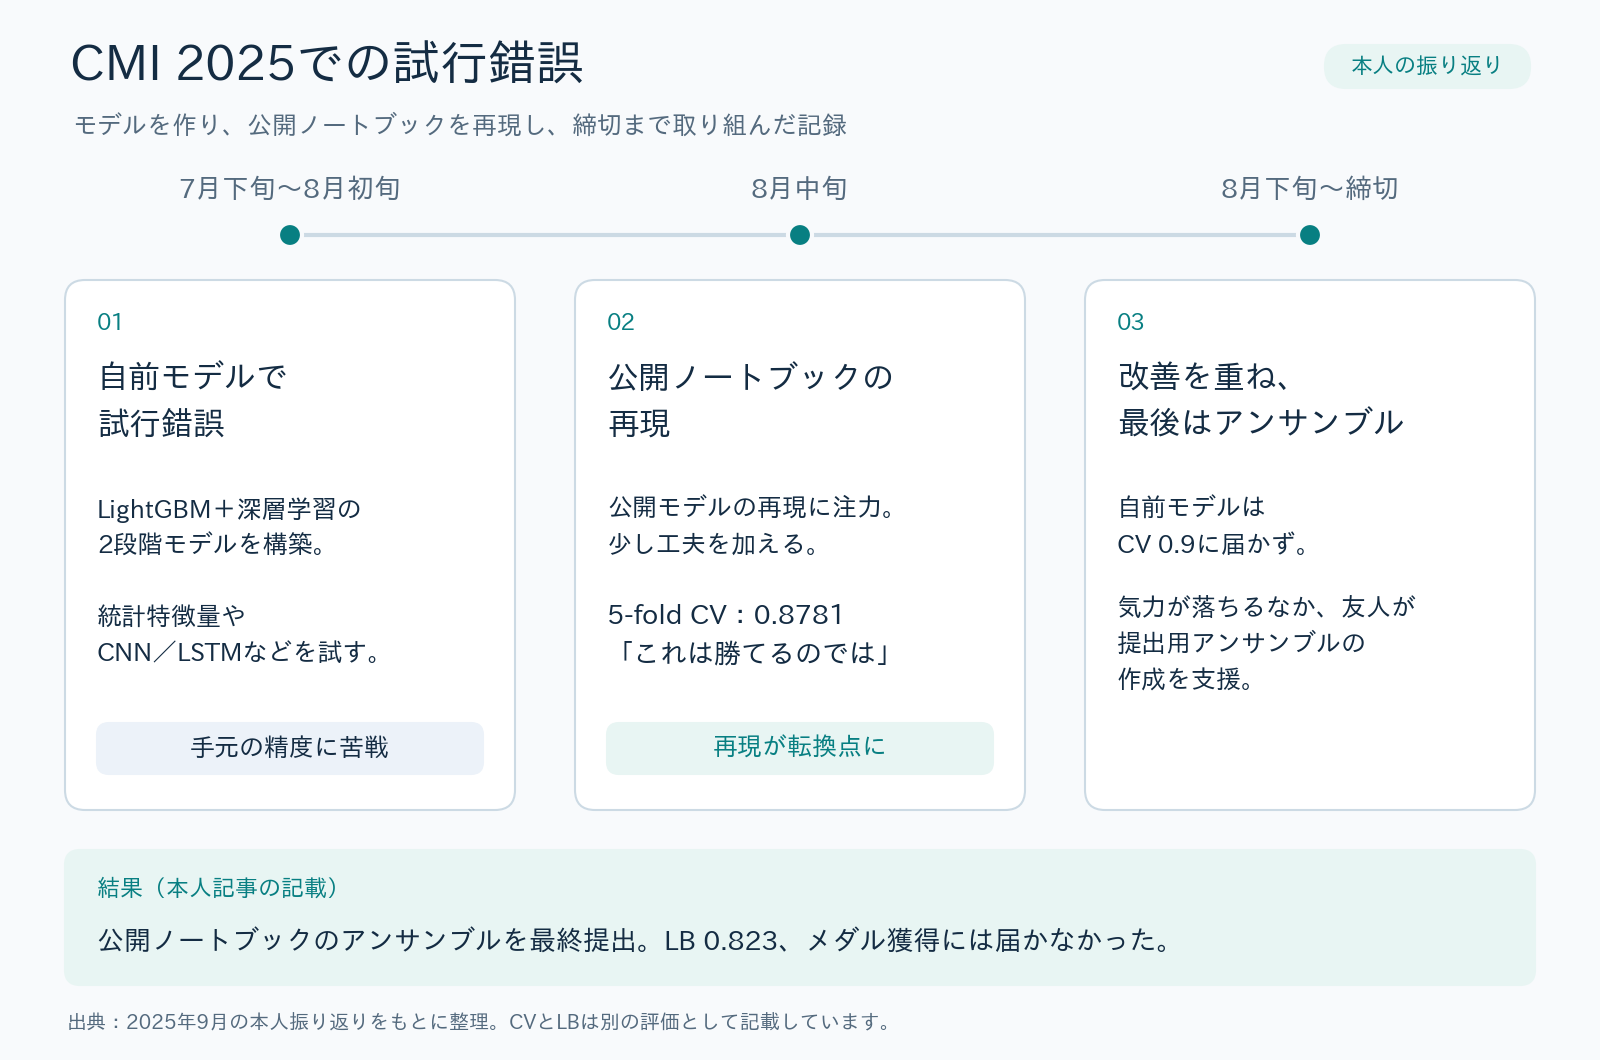
自分で考えて積み上げたものが、そのままスコアにつながるわけではありません。公開ノートブックの再現にも思った以上に時間がかかり、「自分で作っていればそのうち超えられる」というほど簡単ではないと痛感しました。
3. その数値にはどんな根拠があるのか
公開ノートブックを使うときは、スコアの高さに加えて改善の根拠も確かめたいところです。
僕が特に警戒しているのは次のようなものです。
- Publicのスコアに合わせ込む型アンサンブルの重みや閾値を細かく変え、Publicが上がったことだけを根拠に採用している。手元の検証でも改善するかは分からない。
- 乱数やノイズで当たりを引く型seedを変えたり予測にノイズを加えたりして何度も提出し、たまたまPublicが良かったものを残している。
- 根拠不明の補正を積み重ねる型特定の予測に係数を掛けるなどの補正が入っているものの、その理由や検証結果が説明されていない。
- CVの数字だけ立派な型本来分離すべき人物・グループ・時系列が学習と検証にまたがるなど、検証の設計に問題がある。高いCVが未知のデータでの強さを示していない。
- フォークを重ねて変更の意味が分からなくなった型コピーと微調整を繰り返すうちに元の実装や変更理由を追えなくなり、どの工夫が改善に貢献したのかも分からない。
- 再現に必要な情報が足りない型必要なモデルや前処理の手順、ライブラリの条件が揃っておらず、掲載された結果を検証できない。
重みの調整やフォーク自体は普通の手法です。見るべきなのは変更の根拠を追えて、自分の検証でも確かめられるかという点です。
CMIにもアンサンブルの重みを変えた派生ノートブックがありました。例えば「Just Changed the Ensemble Weights」では、予測を混ぜる重みが0.5 / 0.5から0.4 / 0.6へ変更されています。比較した公開版の実行コードでは、この一行が差分でした。元ノートブック・重みを変更した版
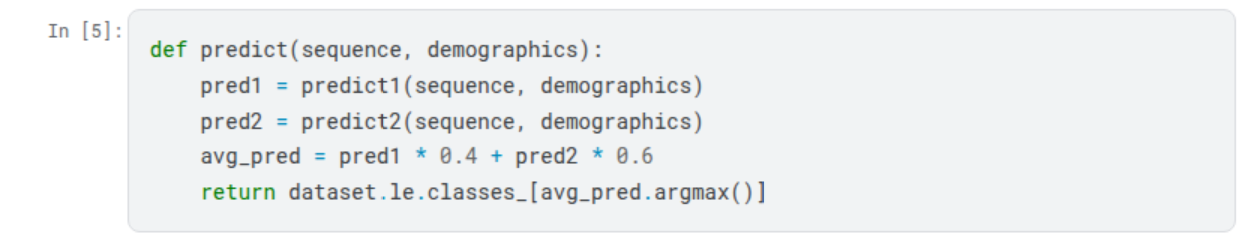
この変更だけで過適合とは言えません。ただ自分が使うなら、その重みで自分のCVも改善するのかを確認します。
理由が分からないまま数値だけを持ってくると、提出するたびにスコアへ振り回されます。僕が「黒魔術」と感じるのはこの状態です。根拠のわからない数値を自分で確かめずに採用するのは、僕としては論外だと思っています。
派生ノートブックを読むときは元になったものも見に行きます。多少スコアが低くても、自分の環境へ移して検証するためのベースラインとしては十分使えます。
最近はAIエージェントを使ってノートブックをPythonファイルに書き換え、自分の実験環境に取り込むところから始めることが多くなりました。
4. ROGIIでメダルを取ったときもTrust CVだった
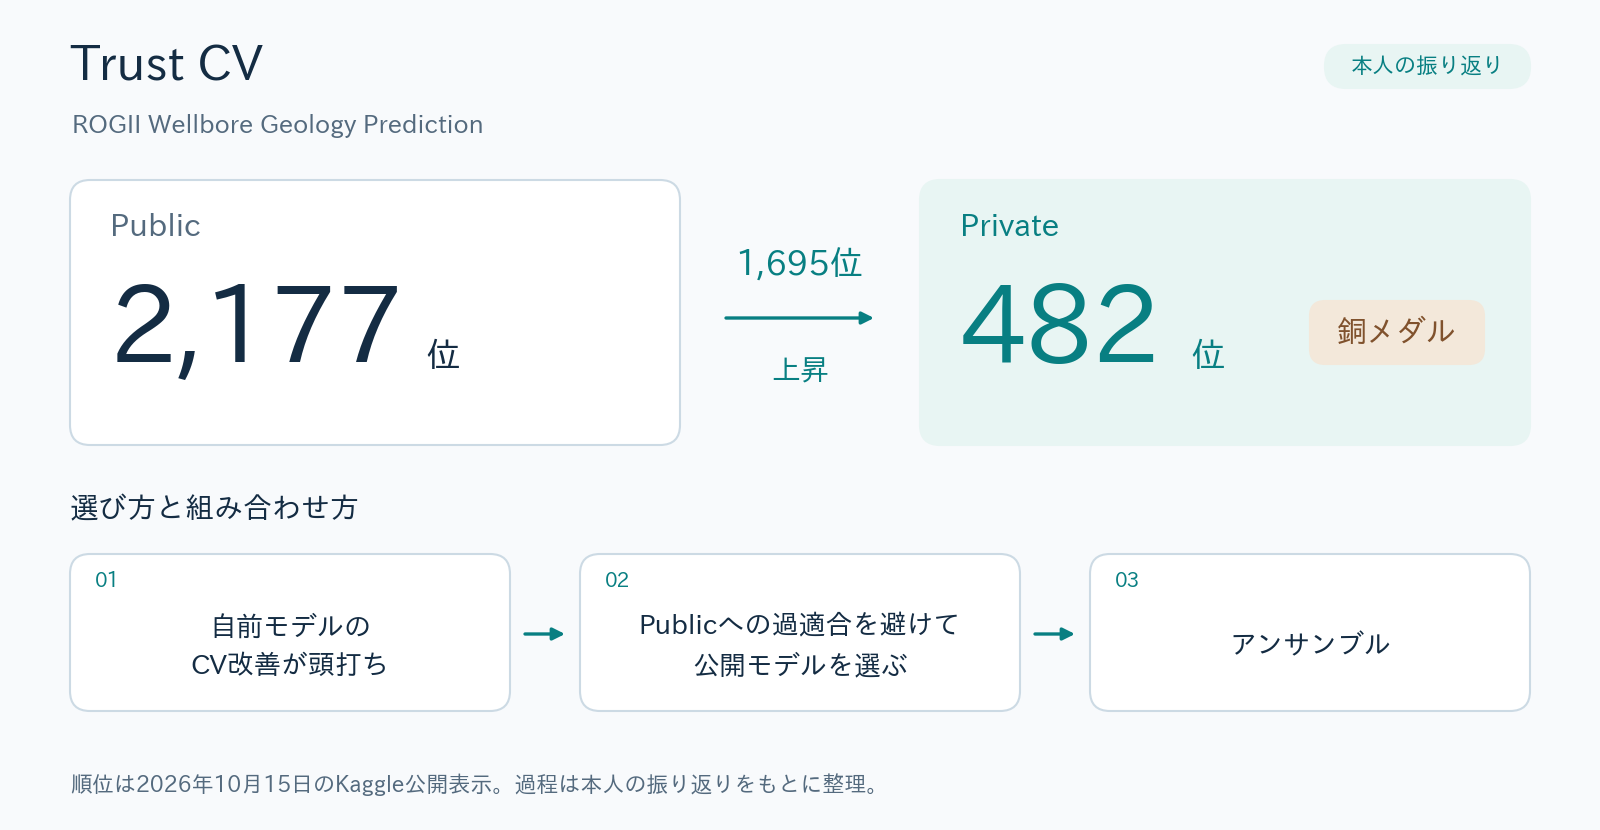
ROGIIでは自前モデルのCVを詰めることに限界を感じ、最後に公開ノートブックも取り入れたアンサンブルへ進みました。
そのときもPublicへの過適合には気をつけていました。当時の記憶では、公開スコアに過度に合わせ込まれていなさそうなものを選んだはずです。判断の軸はTrust CVでした。
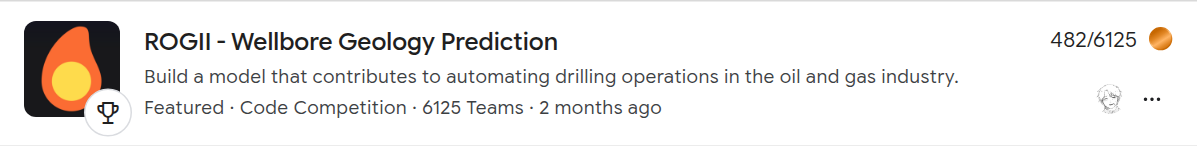
ROGIIでは開催中のPublic順位と最終評価のPrivate順位が大きく変わりました。自分の場合はPublic 2,177位からPrivate 482位となり、銅メダルを獲得しています。 最終順位
終了後には、公開ノートブック系統を調整した35提出でPublicとPrivateのスコアの相関が−0.037だったという参加者の報告も出ています。そのチームではPublicで最も良かった提出がPrivateでの最良にはならず、公開スコアの微改善を追う難しさが表れていました。参加者の検証
僕自身も公開ノートブックに助けられました。その力を借りるときにも、自分の検証を軸に何を取り入れるかを判断する。この姿勢は今後も大切にしたいです。
5. AIエージェントを使っても自分が見るべきものはある
公開ノートブックに勝つには、Kaggleへの取り組み方そのものが大事です。
僕が初期の頃から意識していたのは、できるだけすべてのデータを見ることとCVを記録することでした。データから気づいたことを実験にし、結果を確かめて次の仮説を考える。この繰り返しです。
自分でCVを作ってモデルを改善する期間を持つことも勧めたいです。最初のメダルまでには時間がかかっても、その過程で得られるものは多いはずです。
終了の1週間前くらいになって「どう考えても太刀打ちできない」と感じたら、公開ノートブックも取り入れてみる。何を加えると良くなるのかを自分の検証で確かめながら使うのが、僕の勧めたい進め方です。
ここで自分も胸が痛いのですが、最近はAIエージェントに丸投げしていませんか。
ワークフローが終わるのを待っているだけになったり、実験ばかり増えて自分はデータを見なくなったり。身に覚えがあります。
実装を任せられるようになった分、自分が何を見て何を判断するかを意識したいです。少なくとも当面は、人間が主導して考える余地が大きいと見ています。
そのために整えたいのがリポジトリの構成です。データの観察から実験と結果の記録までを扱いやすくしておく。エージェントを動かすハーネスの上に、自分用のミニハーネスを作るようなものです。
僕もunonaoさんのKaggleテンプレートを土台に、AIエージェントと実験を進めるための「Kaggle Agentic Template」を作っています。実験前の仮説と終了後の結果や学びを残し、評価値や提出履歴を整理して次の作業へ引き継ぐ構成です。
会話が切り替わっても過去の試行錯誤を読み直して再開できるので、実験を重ねても経緯を追いやすくなります。データを見て考える余力を残すために、実験を回す手間を減らす。これが僕にとってのミニハーネスです。
6. 苦しいKaggleを続けるために
基本的にKaggleは苦しいです。
Twitterでよく見かける人たちは当たり前のようにメダル圏内に見えますが、そこまでの試行錯誤や負けたコンペのすべてが見えるわけではありません。
必死に努力してメダル圏内へ入っても最後にシェイクダウンすることがあります。CVの詰めが足りず、最終提出をうまく選べないこともあります。
それでつらくなっているなら、取り組み方を変えることも必要です。
自分はもともと体力が少なく、今はパソコンを1日5時間以上使えません。そこでスマホから進められる環境を整え、実験はいつもスマホで回しています。
データを見るときはベッドでiPadを使い、できるだけすべてを確認します。気づいたことをAIエージェントに伝えて実験し、結果を見てまた考える。今はこの形に落ち着いています。
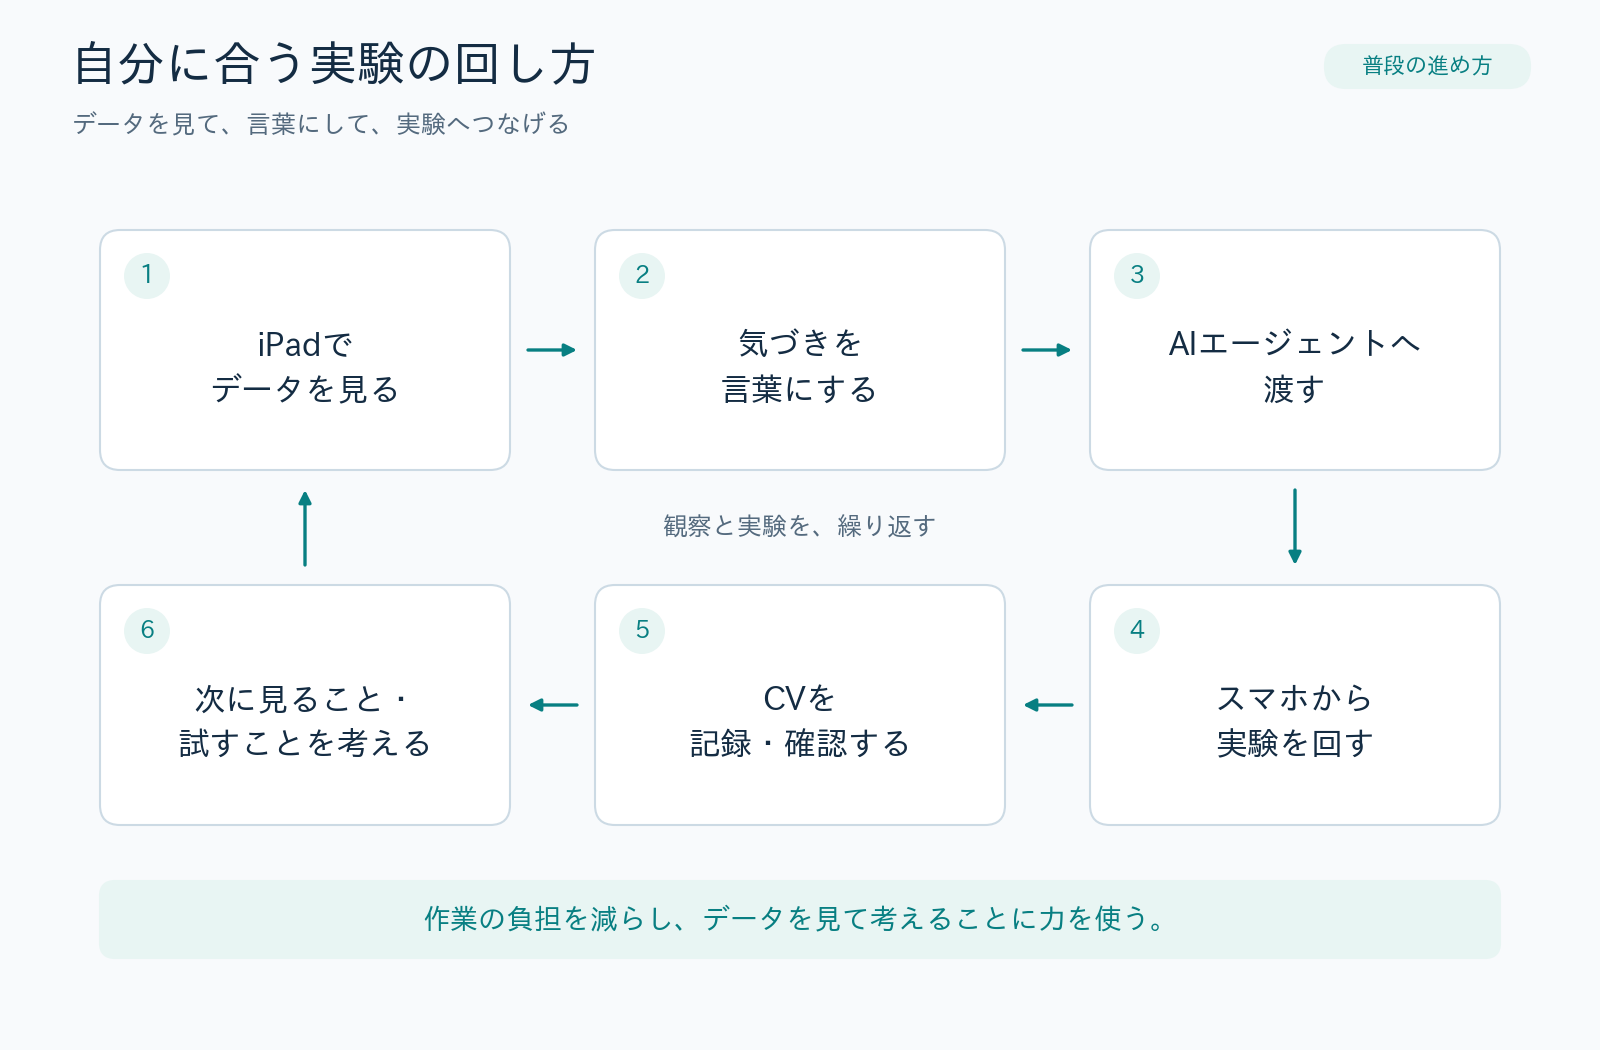
データの観察や結果の解釈には労力をかけたいので、操作や実験を回す負担はできるだけ減らしています。
うまくいかないとすぐに自分を責めたくなりますが、その前に進め方を見直せる余地があります。今の仕組みで続けられるのか、自分はどれくらい集中できるのか、どこを道具に任せれば考える余力が残るのか。
自分の体力や得意不得意も含めて計画を立てることは、長く続けるうえで欠かせません。
7. Expertになってもまだ途中
Expertにはなりましたが、データサイエンティストとしての知識不足は今も感じています。今後はMasterや金メダルが実力の目安としてさらに重視されると考えているので、ここで満足するつもりはありません。
AIエージェントや公開ノートブックのおかげで、Expertまでの道のりは短くなっているのかもしれません。それでも自分には1年半もかかりました。
CMIでは自前モデルが伸びず、公開ノートブックの強さに苦戦しました。ROGIIでは最後にその力も借りてメダルに届きましたが、今でも公開ノートブックに負けることはよくあります。
これからもデータを見て検証し、自分で判断できることを増やしていきます。体力に合う仕組みを整えながら、自分のペースで続けていきたいです。
ネットの情報に振り回されず、自分の検証と積み重ねを信じて戦う。これからもそうやって続けていきます。